Guía · Audiovisual · Intermedio · Generación
La ficha de continuidad: que tu personaje no cambie de cara en video
Tu personaje aguanta una foto; en video, a los tres segundos ya es otra persona. El método para encadenar clips por el ÚLTIMO FOTOGRAMA y sostener la misma cara 16 segundos, con los dos prompts probados en Veo 3.1 Lite y el hallazgo que nadie cuenta: la ficha cuida a la persona, no al lugar.
¿Qué es esto y cómo lo uso?
Una guía paso a paso. Síguela de arriba hacia abajo desde tu celular; no descargas nada.
Objetivo
Lograr que un personaje generado con IA siga siendo LA MISMA PERSONA a lo largo de varios clips de video, encadenándolos por el último fotograma: generas el clip 1, extraes su último cuadro y ese cuadro abre el clip 2. Aquí están los dos prompts completos ya probados en Veo 3.1 Lite, el bloque base que se repite en cada eslabón, los comandos exactos de ffmpeg para sacar el fotograma y unir los clips, las cuatro reglas medidas, y el hallazgo que sale caro descubrir solo: la ficha cuida a la PERSONA, no al LUGAR — el fondo y los accesorios no se heredan, así que el escenario hay que redescribirlo en cada clip.
El problema que esto resuelve
Tu personaje aguanta una foto. En el video, a los tres segundos ya es otra persona.
Te pasó: generaste un avatar perfecto, lo mandaste a animar, y en el segundo 4 la cara ya no era la misma. Otra nariz, otra mandíbula, otro peinado.
No es que el modelo sea malo. Es que cada clip empieza de cero. Le das una imagen, se inventa ocho segundos, y cuando le pides el siguiente clip vuelve a inventar desde otra imagen distinta. Nadie le está pasando el hilo.
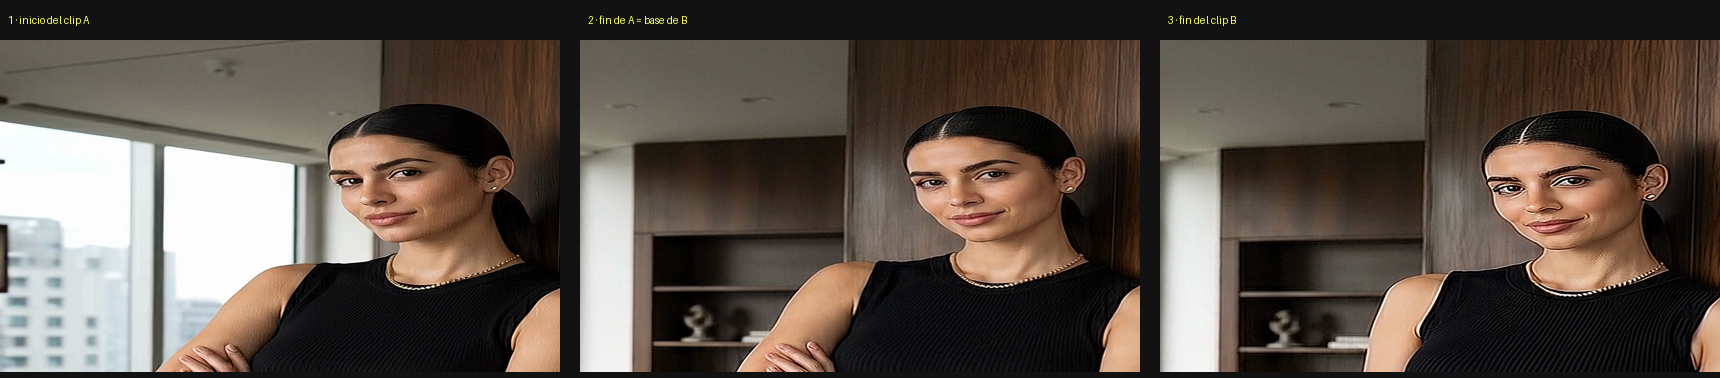
La solución tiene nombre y viene del cine: la ficha de continuidad. En un rodaje alguien lleva una ficha para que el actor no cambie entre tomas — mismo peinado, mismo reloj, misma cicatriz. Aquí es exactamente lo mismo, y la ficha es un solo fotograma.
Esa es la prueba: dos generaciones distintas, una misma persona.
Lo que necesitas
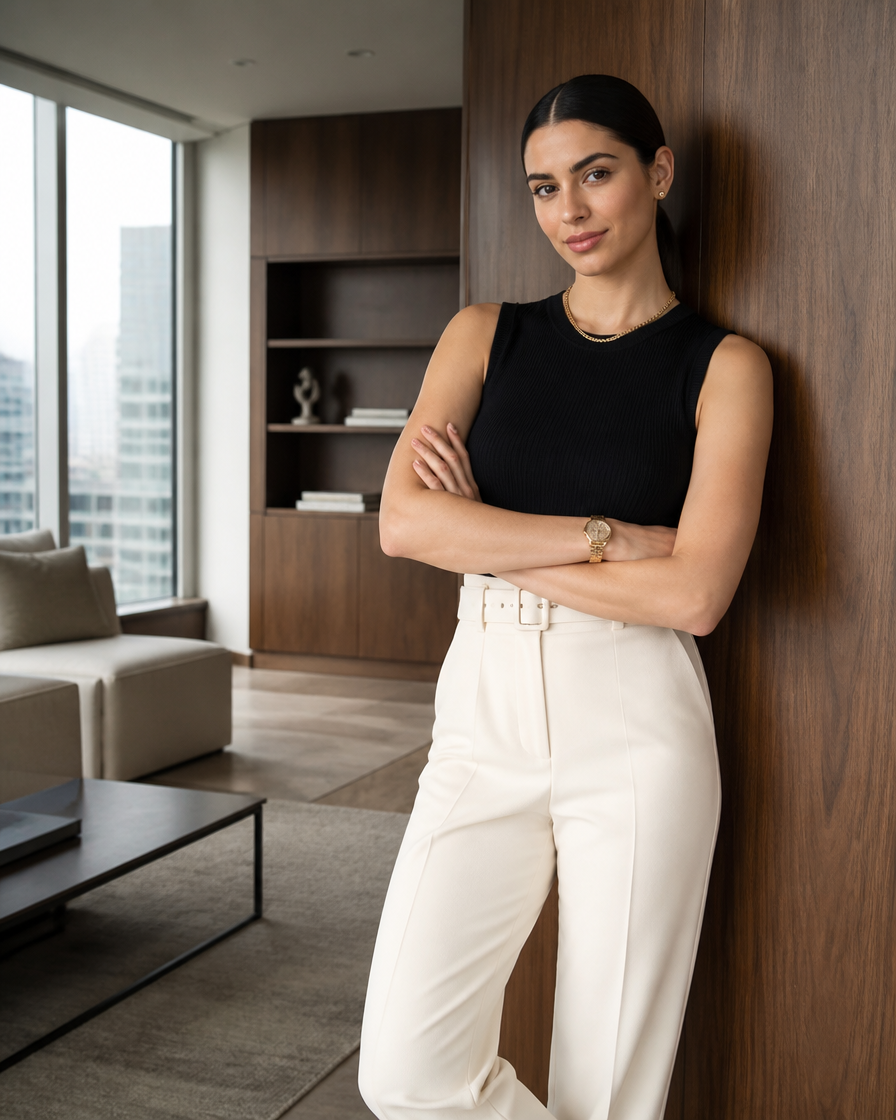
- Una imagen base de tu personaje. Puede ser una foto real o generada con IA. Deja aire alrededor: el modelo reencuadra más cerca de lo que le des.
- Un modelo de imagen a video que acepte imagen base (aquí, Veo 3.1 Lite).
- ffmpeg, o cualquier editor que te deje exportar un fotograma y unir dos clips. Son dos comandos, están abajo completos.
El bloque que se repite en TODOS los clips
Esta es la ficha escrita. Cambia solo la descripción del personaje y del lugar por los tuyos, y pégala completa al inicio de cada clip — del primero y de todos los que sigan.
Ver el prompt completo ↓Plegar el prompt ↑
$ The woman stays exactly as she is: same face, same features, same dark hair pulled back into a low ponytail with a centre part, same gold chain, same gold watch on her left wrist, same clothes, same setting and same light. Do not redraw her, do not change her identity, do not alter her face in any way.

CAMERA: locked off on a tripod, completely still. No push-in, no pan, no handheld shake, no zoom.

The light and the background stay constant throughout.

Photorealistic, natural daylight, continuous single take. No text, no captions, no subtitles, no graphics.Fíjate en lo que se nombra: el peinado, la raya en medio, la cadena de oro, el reloj dorado en la muñeca izquierda, la ropa. No es relleno. Es la lista de lo que el modelo no puede tocar. Todo lo que no le nombres, se lo inventa de nuevo.
Lo único que cambia entre un clip y otro es el bloque de MOVIMIENTO: qué hace el personaje en esos ocho segundos.
Paso 1 · Graba el primer clip
Movimiento lento y cámara quieta. Que respire, que parpadee, que se le mueva el pelo — pero que no gire la cara. Ocho segundos.
Es el clip que va a producir la ficha, así que todo lo que salga raro aquí se hereda después.
Ver el prompt completo ↓Plegar el prompt ↑
$ The woman stays exactly as she is: same face, same features, same dark hair pulled back into a low ponytail with a centre part, same gold chain, same gold watch on her left wrist, same clothes. Do not redraw her, do not change her identity, do not alter her face in any way.

MOVEMENT: extremely subtle and natural. She breathes, blinks twice, and a few strands of hair move very slightly. Her head stays facing the camera the whole time — it does NOT turn, rotate or tilt. Her expression stays calm and steady, with the faintest settling of a smile.

CAMERA: locked off on a tripod, completely still. No push-in, no pan, no handheld shake, no zoom.

The light and the background stay constant throughout.

Photorealistic, natural daylight, continuous single take. No text, no captions, no subtitles, no graphics.Los ajustes con los que se generó: duración 8 s, resolución 1080p, relación 9:16. Y el negative prompt, que es media guía en sí mismo:
$ on-screen text, captions, subtitles, watermark, face morphing, identity change, different person, head turning, head rotating, camera shake, cuts, zoomPaso 2 · Saca el último fotograma
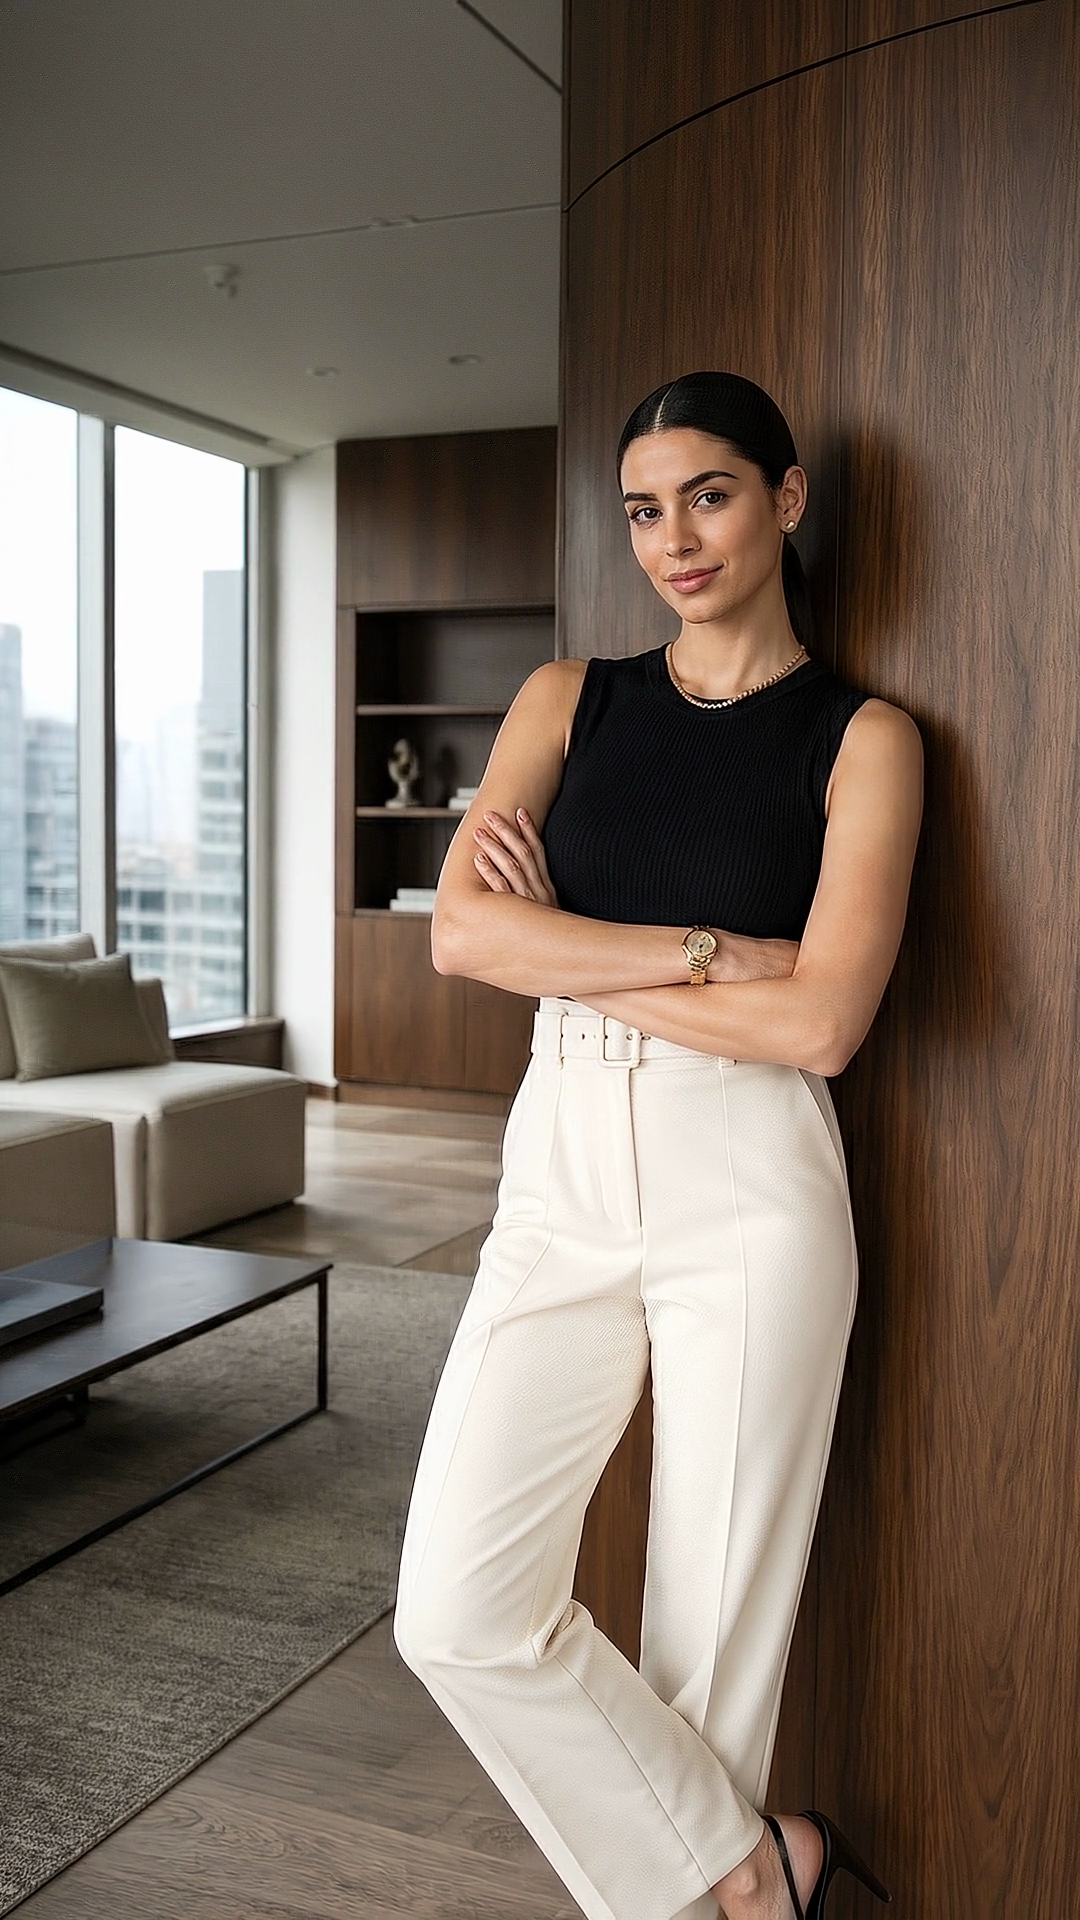
Ese fotograma es la ficha. De ahí sale todo lo demás.
$ ffmpeg -sseof -0.1 -i clip-1.mp4 -vframes 1 ficha.png-sseof -0.1 se para a una décima de segundo del final y -vframes 1 exporta un solo
cuadro. Si no usas ffmpeg, sirve igual el "exportar fotograma" de cualquier editor: lo que
importa es que sea el final del clip, no un cuadro cualquiera de en medio.
Paso 3 · Ese fotograma abre el clip 2
Súbelo como imagen base del siguiente clip, pega otra vez el bloque base —el personaje Y el lugar— y cámbiale solo el movimiento.
Ver el prompt completo ↓Plegar el prompt ↑
$ The woman stays exactly as she is: same face, same features, same dark hair pulled back into a low ponytail with a centre part, same gold chain, same gold watch on her left wrist, same clothes, same setting and same light. Do not redraw her, do not change her identity, do not alter her face.

MOVEMENT: she lifts her right hand slowly and gestures once toward the space beside her, as if presenting it, then lets the hand settle back down. Her head stays facing the camera throughout — it does NOT turn, rotate or tilt away. Her expression stays calm, with a small steady smile.

CAMERA: locked off on a tripod, completely still. No push-in, no pan, no handheld shake, no zoom.

The light and the background stay constant, identical to how the shot begins.

Photorealistic, natural daylight, continuous single take. No text, no captions, no subtitles, no graphics.Y los unes. Con ffmpeg son dos pasos: un archivo de lista y un concat sin recomprimir.
$ printf "file 'clip-1.mp4'\nfile 'clip-2.mp4'\n" > lista.txt
ffmpeg -f concat -safe 0 -i lista.txt -c copy encadenado.mp4Ahí tienes los 16 segundos. Y el mismo fotograma final del clip 2 abre el clip 3, si quieres seguir alargando.
El hallazgo: la ficha cuida a la PERSONA, no al LUGAR
Esto es lo que no vas a leer en ningún tutorial, y es lo que más caro sale descubrir solo.
La cara aguantó perfecta los 16 segundos. El cuarto se reinventó solo.
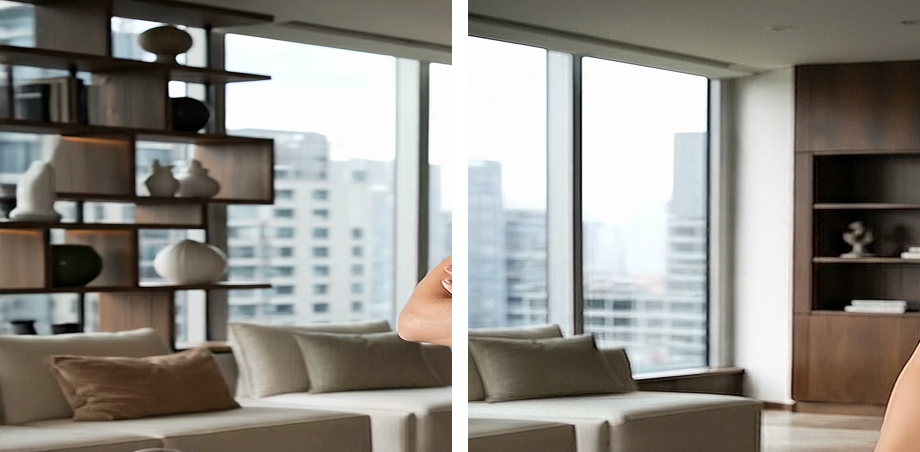
El librero con jarrones que estaba frente al ventanal en el clip A desapareció en el clip B. Y el reloj pasó de dorado a plateado entre un clip y otro.
Lo que hereda el modelo es el fotograma, no tu intención. Reconoce la cara porque la ve en la imagen; lo que estaba fuera de cuadro, o lo que solo se intuye borroso al fondo, se lo vuelve a inventar.
Las cuatro reglas medidas
Esto es lo que salió de la prueba, no lo que dice el manual del modelo:
- Movimiento lento y cámara quieta, siempre. En cuanto el personaje gira la cara, se deforma. Lo que se mueve es el aire, la luz, la ropa, una mano. No la cabeza.
- Si hay texto a la vista, corta en el segundo 6. Medido en la misma familia de pruebas: una etiqueta que decía ARTESANAL se convirtió en ARTSSANAL. Sin texto en cuadro, el clip aguanta los 8 completos.
- Veo reencuadra más cerca de lo que le das. Deja aire alrededor del sujeto en la imagen base o te recorta la composición sin avisar.
- Los accesorios derivan. El reloj pasó de dorado a plateado entre clip y clip. Revisa reloj, joyería y detalles de ropa antes de dar el encadenado por bueno.
Cómo adaptarlo a tu personaje
Los prompts no se reescriben. Solo cambias tres cosas:
- La descripción física del personaje. Donde dice
same dark hair pulled back into a low ponytail with a centre part, same gold chain, same gold watch on her left wrist, pon los rasgos de tu personaje con el mismo nivel de detalle: peinado, color y forma, joyería, ropa, cualquier marca o accesorio que lo identifique. - La descripción del lugar. Súmale al bloque base una o dos líneas con el escenario concreto —los muebles, la ventana, el material de la pared— y repítelas idénticas en cada clip. Es la parte que el modelo pierde.
- El bloque de MOVIMIENTO. Es lo único que cambia entre eslabón y eslabón: en el primero, respirar y parpadear; en el segundo, un gesto de la mano; en el tercero, lo que necesites. Uno por clip, y lento.
Lo que NO se toca: el Do not redraw her, do not change her identity, el bloque de
CAMERA: locked off on a tripod, el head stays facing the camera... it does NOT turn y la
línea final de no text, no captions, no subtitles. Ese es el sistema. Si los recortas para
ahorrar texto, se degrada justo esa parte del resultado.
Lo que hay que cuidar
- El último fotograma es el contrato. Si el clip 1 termina con la cara movida, los ojos a medio cerrar o una mano rara, el clip 2 nace de ahí y arrastra el defecto. Si no te gusta el fotograma final, no sigas: regenera el clip 1.
- Esto está probado hasta dos eslabones (16 s). Funciona, pero la deriva se acumula: revisa cada encadenado completo antes de sumarle el siguiente clip, no al final de cinco.
- Revisa fondo y accesorios cuadro por cuadro, no solo la cara. La cara es la que aguanta; lo que traiciona el encadenado son los muebles, el reloj y las joyas.
- Veo solo entrega 9:16 y 16:9. No hay 4:5 ni 1:1. Para publicar en 4:5 el truco es:
mete tu imagen de 1080×1350 centrada en un lienzo negro de 1080×1920, genera en 9:16, y
recorta de vuelta la ventana central. En ffmpeg, el recorte exacto es
crop=1080:1350:0:285. El encuadre queda idéntico al de tu imagen base. - Une sin recomprimir. El
-c copydel concat pega los clips sin volver a codificar: si reencodeas en cada unión, cada eslabón pierde calidad frente al anterior.